AI 에이전트를 사용하다보면 CLAUDE.md, AGENTS.md, .claude/rules/ 같은 지침을 변경할 일이 많다.
지침을 수정한 뒤에 수동으로 프롬프트를 직접 실행해보고 결과를 확인하거나, 세션 파일을 열어서 원하는 순서로 관련 파일을 읽는지, 의도한 작업을 실행하는지, 원하는 결과물인지 등을 확인해야 했는데 이게 꽤 귀찮았던 것 같다 (물론 이 분석을 AI에게 맡기면 잘해주긴 한다).
그리고 변경한 지침이 효과가 있는지 알려면 변경 전후로 테스트해야 하는데, 결과가 매번 조금씩 확률적으로 달라질 수 있다보니 1~2번 실행해본 것으로 판단하기에 애매하다고 느꼈던 것 같다.
또 지침을 변경한 뒤에 ‘뭐가 더 나은지’를 정성적으로 판단할 근거를 다른 사람에게 설명하기 어려운 부분이 있었다. 성공 기준을 명확하게 정해놓고 결과를 보여줘야 하는데 매번 그러기엔 번거로우니까 내 기준에선 그냥 수정된 지침을 보고 더 나아지겠지 라는 기대 정도를 갖고 판단했었다. 예를 들어 2~3번 돌려보고 잘 수행하면 그걸 성공이라고 판단하는 식으로.
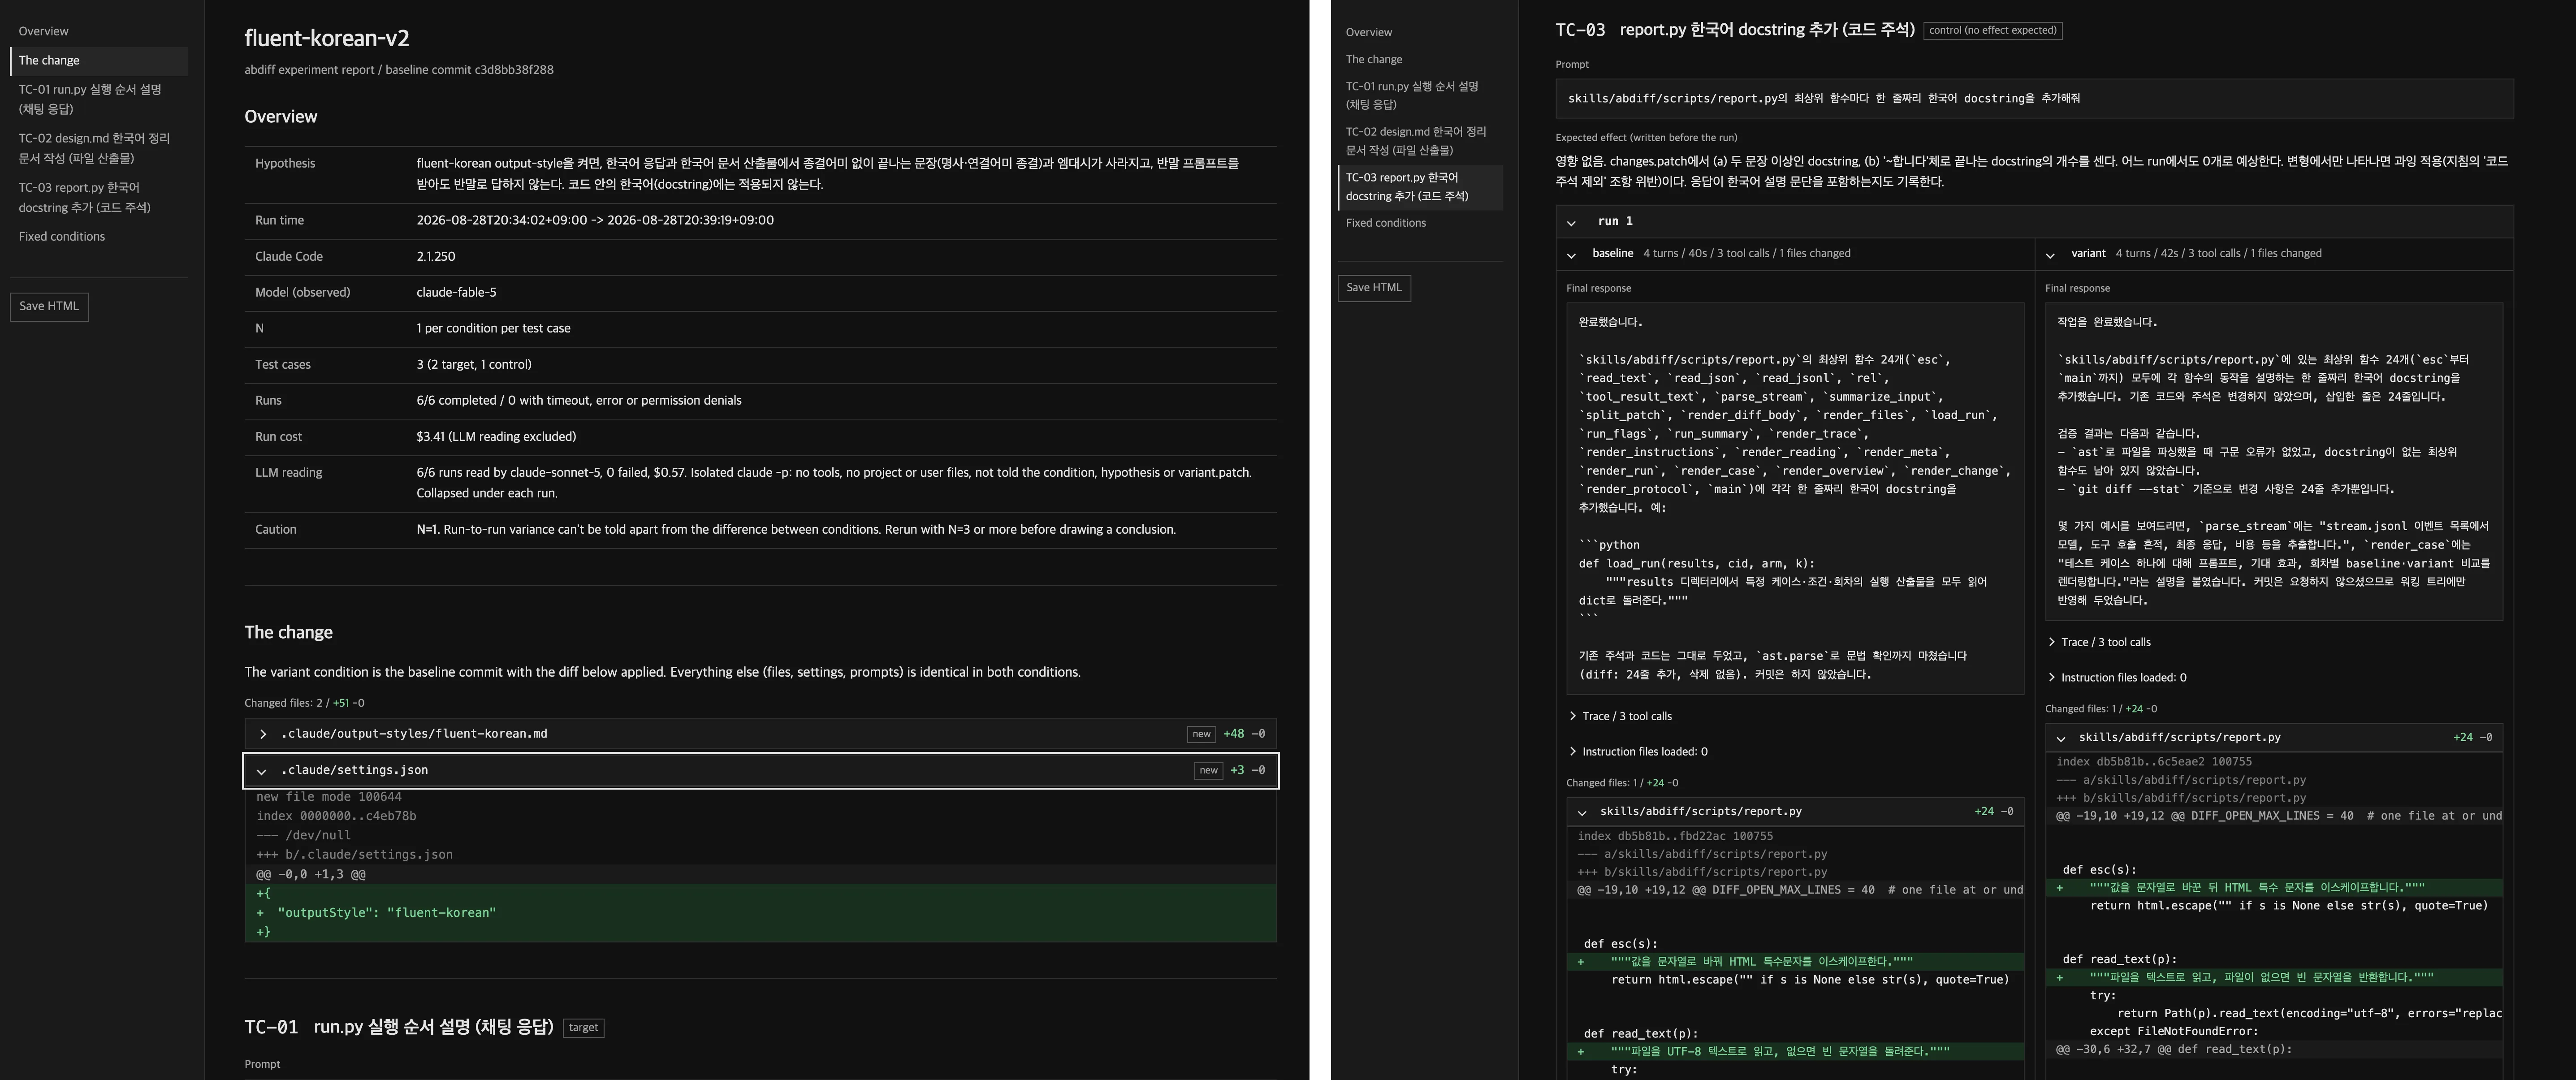
뭔가 좋은 방법이 없을지 고민하다가, 예전부터 Anthropic의 공식 스킬 skill-creator를 자주 사용하고 있었는데, 해당 스킬에서는 스킬 적용 전후를 보고서 형태의 페이지로 서버에 띄워서 결과를 비교할 수 있는 기능이 있다.1 평소에 이 비교하는 방식 자체가 꽤 유용하다고 느꼈는데, 이 방식을 차용하여 지침을 변경했을 때 결과에 어떤 변화가 있는지 볼 수 있는 스킬을 만들었다.
작동 방식은 간단하게 기존 환경 A와 변경된 환경 B를 두고 나머지는 동일하게 유지한 상태로 미리 준비된 여러 프롬프트를 각각 여러 번 실행한 뒤, 결과를 A / B 형태로 보여주는 방식이다. 그리고 나서 A, B가 각각 어떤 Tool Call이 발생했는지 어떤 지침 파일을 읽었는지를 보여준다.
예를 들어 아래와 같은 상황을 테스트할 수 있다.
- 기존 60줄의 지침을 40줄로 압축했을 때, 기존과 동일하거나 비슷한 수준의 결과가 나오는지
- 관련 없는 규칙을 많이 추가해 지침이 길어졌을 때 특정 규칙을 여전히 따르는지
- 특정 컨텍스트(문서 또는 코드) 여부에 따라 어떤 결과 차이가 발생하는지
- ‘어떤 상황에서는 특정 도구를 써라’라는 지침을 적용했을 때, 실제로 도구를 사용하는지
- 변경 이후 예상한 내용이 결과에 포함되는지.
나는 보통 지침 변경 전후나 컨텍스트 유무에 따라 결과에 유의미한 차이가 생기는지 보고 싶을 때 쓰는 것 같다. 다만 모델의 영향이나 변수를 완벽히는 통제하기 어려워서 어떤 경향을 보이고, 정성적으로 뭐가 더 좋아보이는지 판단하는 근거 정도로 사용하고 있다.
참고
- Effective context engineering for AI agents (Anthropic Engineering)
- skill-creator SKILL.md (anthropics/claude-plugins-official)
Footnotes
-
스킬 적용 전후를 같은 프롬프트로 돌려서 토큰을 얼마나 소비하는지, 실행 시간은 어떻게 차이나는지, 어떤 결과가 나오는지 비교할 수 있는 리포트를 제공한다. ↩